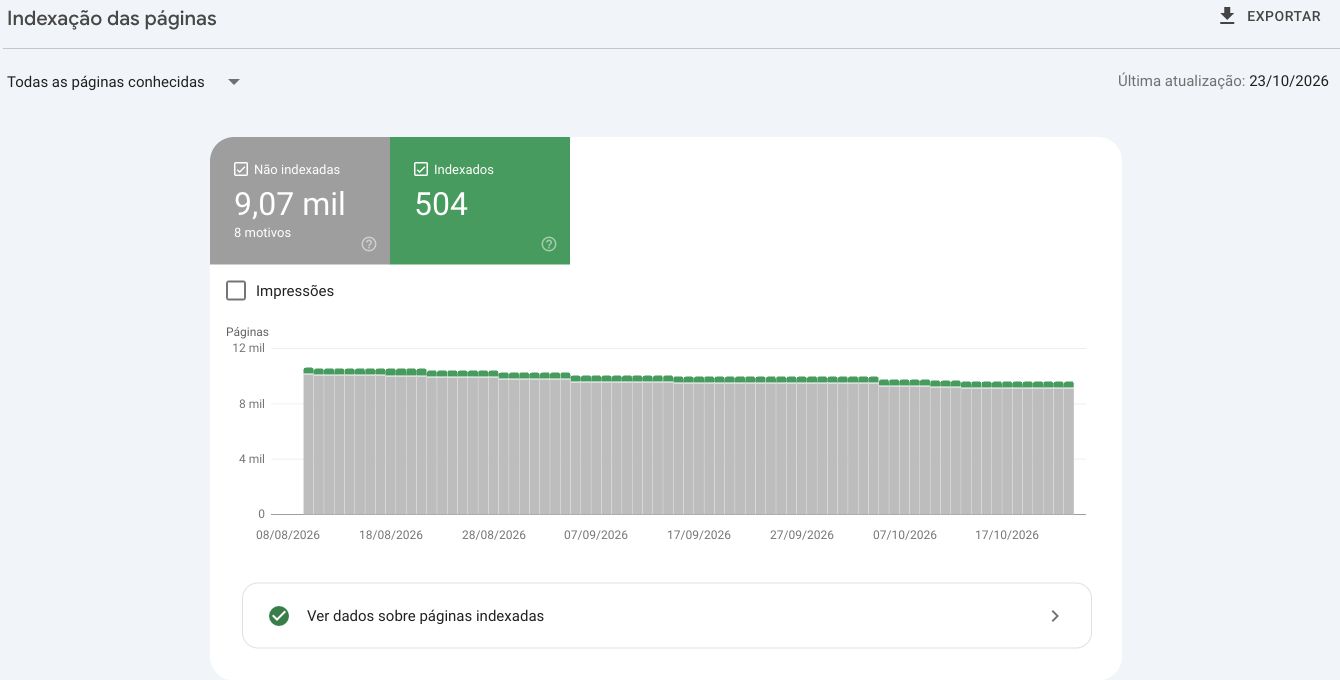
L’audit Search Console chez iEducação a commencé par une décision : distinguer les défaillances techniques des exclusions volontaires. Le rapport indiquait 9 073 URL non indexées, mais ce nombre ne représentait pas 9 073 erreurs à éliminer.
Le travail a relié la lecture des rapports à la configuration réelle de WordPress : indexation, redirections, pagination, données structurées et composants qui influencent l’expérience de navigation. Les étapes ci-dessous expliquent ce qui a été fait et pourquoi chacune précédait la suivante.
La source est le rapport technique fourni par le responsable d’iEducação.
1. Documenter la situation avant de modifier le site
- Confirmer la propriété HTTPS et les dates de mise à jour des rapports.
- Exporter les exemples et croiser les URL avec l’inventaire WordPress.
- Consigner les directives, sauvegardes et empreintes avant de modifier les réglages.
La première étape consistait à vérifier la bonne propriété HTTPS et la date des données. Le rapport d’indexation était à jour au 23 octobre ; celui des Core Web Vitals, au 3 novembre. Ces repères permettaient de comparer l’historique de Google aux réponses actuelles du site.
Les tableaux disponibles ont été exportés et croisés avec l’inventaire WordPress : 418 articles, 24 pages et 293 contenus de type PDF, soit 735 contenus publiés. Les directives individuelles de Rank Math, les catégories, les sitemaps et les composants partagés ont également été recensés.
Avant les modifications, des sauvegardes ont été réalisées et des empreintes calculées. Ces identifiants permettent de détecter les changements de contenu. L’implémentation a comparé l’état antérieur pour protéger les modifications simultanées. Cette préparation a défini le périmètre des corrections et la possibilité d’un retour arrière ciblé.
2. Définir ce qui devait apparaître dans Google
Contenus éligibles à la recherche
Les URL ont ensuite été classées selon leur fonction. Les articles, pages et catégories pouvaient être éligibles à la recherche, dans le respect de leurs réglages individuels. Les profils d’auteur avec biographie et publications ont conservé leur contexte éditorial ; les profils vides ont reçu la directive noindex pour rester hors des résultats.
Exclusions volontaires
Les pages d’accès aux PDF, les étiquettes, les recherches internes et les flux devaient rester accessibles aux lecteurs, mais hors de l’index. Cette politique est propre au projet. Un autre site peut avoir des archives d’étiquettes ou des documents qui méritent d’être indexés ; la décision dépend du contenu et de la fonction de chaque adresse.
Le groupe des variantes canoniques réunissait les URL qui désignaient une autre version comme préférée. Parmi les 1 000 exemples exportables, 999 comportaient des paramètres. La décision a été de conserver la consolidation de ces variantes et d’étudier séparément la pagination qui modifiait réellement le contenu.
3. Aligner robots.txt et noindex
Le conflit le plus direct concernait 24 URL indexées et bloquées par robots.txt. Il s’agissait de flux et de recherches internes. L’objectif était de les exclure de la recherche, mais le blocage empêchait Google d’accéder à la réponse et de lire le noindex.
La correction a consisté à autoriser l’exploration de ces chemins publics tout en conservant la directive d’exclusion, dans la balise meta ou l’en-tête HTTP selon le document. Robots.txt a continué à restreindre l’exploration de l’administration, avec l’exception nécessaire pour admin-ajax.php. Les images publiques sont restées explorables.
Il existait aussi des divergences entre le fichier physique, la configuration de Rank Math et une copie en cache dans Cloudflare. Ces sources ont été alignées et le cache de cette URL a été invalidé de façon ciblée. Une nouvelle lecture de robots.txt a ensuite été demandée.
Dans WordPress, la politique noindex a été renforcée pour les 293 contenus de type PDF. Deux exceptions individuelles de Rank Math ont été corrigées. Les documents bureautiques et les PDF servis par le site ont reçu une règle X-Robots-Tag ; les fichiers hébergés sur Drive restent soumis au service qui les distribue.
1. Autoriser l’exploration : ouvrir le chemin public que Google doit lire.
2. Fournir le noindex : vérifier la balise meta ou l’en-tête HTTP de la réponse.
3. Suivre l’exclusion : demander une nouvelle lecture et observer le traitement dans Search Console.
Pour appliquer cette procédure à un autre site, la référence est la documentation de Google sur noindex : le robot doit pouvoir accéder à la page pour lire la directive. Autoriser l’exploration et autoriser l’indexation sont deux décisions distinctes.
4. Corriger la pagination et rétablir des chemins équivalents
Dans la collection /pdf-gratuito/, GenerateBlocks utilise le paramètre query-a66c71a4-page pour changer les ressources affichées. La deuxième page présente un contenu différent de la première. Le filtre canonical a donc été adapté pour reconnaître la requête réelle et les limites de la pagination.
Une page valide conserve sa propre adresse canonique. Un paramètre de campagne, comme utm_source, est retiré du canonical lorsqu’il ne change pas le contenu. Les valeurs invalides ou hors limites reçoivent noindex. Les réglages canoniques individuels déjà présents dans Rank Math ont été conservés.
Pour les anciens chemins, 28 règles exactes de redirection 301 ont été créées. L’ancienne page 1 de la catégorie pointe vers la collection actuelle ; les suivantes, vers la position correspondante. Par exemple, /categoria/pdf-gratuito/page/7/ mène à /pdf-gratuito/?query-a66c71a4-page=7.
Les anciennes adresses AMP ont été traitées selon l’existence d’un article ou d’une page publiée équivalente. Les chemins supprimés sans équivalent ont conservé une réponse 404 ou 410. Le critère était de rétablir un lien réel entre source et destination, sans tout rediriger vers la page d’accueil.
5. Contrôler les sitemaps et les réponses publiques
Une fois la politique définie, le sitemap, le plan des URL fourni aux moteurs, a été comparé à l’inventaire. Il réunissait 457 URL : 418 articles, 25 entrées dans le sitemap des pages, accueil compris, et 14 catégories. Les contenus de type PDF en étaient exclus.
Le contrôle public a porté sur ces 457 URL, les 293 pages de PDF et 12 adresses supplémentaires, soit 762 vérifications. Les 28 nouvelles redirections ont fait l’objet d’un contrôle séparé. Cette répartition clarifiait les attentes de chaque groupe : accès et éligibilité, accès avec exclusion ou redirection.
Les 66 exemples historiques d’erreurs serveur ont également été testés. Comme aucune erreur 5xx n’a été reproduite, une validation a été demandée pour ce problème précis. L’adresse technique /wp-*.php, qui renvoyait 403, a conservé sa protection.
6. Corriger les données structurées avec des informations réelles
Dans le balisage vidéo, quatre objets n’indiquaient pas l’adresse de la miniature, le champ thumbnailUrl, et deux présentaient des problèmes de date. Les métadonnées des véritables vidéos YouTube ont été vérifiées, puis six objets VideoObject ont reçu les miniatures correspondantes, des titres précis et les dates originales au format ISO 8601 avec fuseau horaire.
La date utilisée était celle de la première publication de chaque vidéo, selon la source, et non le jour de la maintenance. La procédure suivait les exigences de Google pour les données structurées vidéo. Le contenu commercial des pages a été conservé.
Le rapport distinct d’indexation vidéo a été interprété selon la fonction des pages : les vidéos complétaient les articles. Aucune page de lecture artificielle n’a été créée dans le seul but de modifier cet indicateur.
Pour les commentaires, le retrait antérieur de microdonnées incorrectes a été vérifié, en gardant les textes visibles. La validation des avertissements a été demandée pour faire retraiter cette correction. Le mécanisme créant des équivalences sameAs supposées entre étiquettes et pages Wikipédia a aussi été retiré.
7. Ajuster les publicités et le JavaScript partagés
L’analyse de l’expérience s’est concentrée sur les composants communs. L’historique des données de terrain signalait des problèmes d’INP, qui mesure la réactivité aux interactions, et de CLS, qui mesure les décalages visuels. Des insertions tardives de publicités, des changements de hauteur et un bloc rechargé toutes les dix secondes ont été observés.
Le rechargement automatique a été supprimé, tout en conservant l’affichage initial. Des espaces ont été réservés aux publicités et la séquence de navigation a été maintenue : paragraphe contextuel, publicité et bouton de demande du PDF. L’intégration native d’Ad Inserter a pris en charge deux blocs de téléchargement dans le traitement partagé du contenu, évitant les doublons.
La réservation d’espace exigeait de vérifier les dimensions après le rendu : AdSense appliquait des styles de hauteur qui annulaient une solution simple avec min-height. Les conteneurs communs et les règles adaptatives ont été ajustés sans masquer ni rogner les publicités.
Un essai intermédiaire avec un tampon HTML n’insérait pas correctement la publicité de téléchargement et a été annulé. La solution finale a utilisé la fonction native adinserter(). Il fallait distinguer cet essai de la version finale pour comparer les performances d’une page fonctionnellement complète.
La détection de l’arrivée au pied de page a également changé : les vérifications répétées pendant le défilement ont été remplacées par IntersectionObserver, en conservant l’événement existant, son exécution unique et une solution de repli avec écouteur passif. Les ajustements sont restés dans les fichiers partagés du thème enfant.
8. Vérifier la livraison et lancer les validations Search Console
- Ouvrir les pages sans connexion et vérifier le HTML et les en-têtes HTTP.
- Comparer canonical et noindex à la politique de chaque type d’URL.
- Vérifier les publicités, les boutons et la pagination sur ordinateur et mobile.
- Consigner les mesures finales et demander la validation des problèmes corrigés.
Chez iEducação, cette vérification a couvert l’ordinateur et une largeur mobile de 390 px. Le cache WordPress a été vidé, ainsi que, de façon ciblée, celui des ressources modifiées dans Cloudflare.
Les mesures finales PageSpeed ont été consignées pour l’article sur les lettres de l’alphabet et la catégorie Educação Infantil, sur mobile et ordinateur. Le passage intermédiaire avec une publicité incomplète est resté identifié dans l’historique, à part de la comparaison finale.
Enfin, 11 validations ont été lancées : deux pour l’indexation, trois pour les données structurées vidéo, deux pour les avertissements de commentaires et quatre groupes Core Web Vitals. La demande de nouvelle lecture de robots.txt a été consignée séparément. Aucune demande individuelle d’indexation n’a été effectuée durant cette intervention.
Ce qui a été vérifié et ce qu’il faut suivre maintenant
762 URL vérifiées : toutes ont répondu HTTP 200 lors du contrôle documenté.
293 pages de PDF : toutes avec noindex, conformément à la politique définie.
28 redirections : réponses 301 vers des destinations équivalentes.
Selon le rapport technique, ces indicateurs ont été vérifiés à la fin de l’implémentation. Aucune URL des sitemaps ne portait de noindex indésirable, et les empreintes des 735 contenus publiés sont restées identiques.
Il s’agit de résultats d’implémentation et de vérification. Les 11 validations ont été lancées, mais n’étaient pas encore approuvées à la clôture documentée. Search Console affichait toujours l’historique Core Web Vitals, qui dépend de nouvelles visites et du traitement des données de terrain.
Dans le test mobile des lettres, la note de performance était de 99 avant comme après. Le CLS de laboratoire était déjà nul dans les deux passages. Le Speed Index est passé de 2,925 s à 3,206 s dans la mesure finale. Cette comparaison ne démontre donc ni réduction du CLS historique ni amélioration générale de la vitesse. Les notes finales d’accessibilité, 90 et 92 pour les pages testées, comportaient aussi des avertissements.
Le suivi doit contrôler le résultat de chaque validation, l’exclusion cohérente des flux et recherches, la cohérence des sitemaps et l’évolution de l’INP et du CLS sur le terrain. Pour le trafic, la comparaison doit utiliser des périodes équivalentes et tenir compte des requêtes, des pages et de la saisonnalité scolaire brésilienne.
Aucune mesure ultérieure ne prouve encore un rétablissement des clics, des ventes ou du chiffre d’affaires. L’intervention a créé une base technique pour ce suivi. L’analyse historique du trafic organique et des ventes d’iEducação porte sur une autre période et ne doit pas servir de résultat à ces corrections.
Méthode et limites : cet article synthétise le rapport d’intervention fourni par le responsable, avec l’aide de l’IA pour l’organisation et la rédaction. Les totaux internes sont attribués à ce document ; l’audit de toutes les URL n’a pas été répété ici. Les principaux groupes d’exclusion étaient limités à 1 000 exemples exportables. Les vérifications de laboratoire et de mise en page couvrent les pages et conditions décrites.
Pour approfondir la différence entre test et expérience réelle, lire aussi PageSpeed élevé et site lent : que vérifier avant d’optimiser ?. Les références techniques comprennent la documentation sur l’indexation des pages, noindex, les données structurées vidéo, les Core Web Vitals et l’optimisation du CLS.
Besoin d’organiser ce type de correction technique sur votre WordPress ? Échangeons sur WhatsApp.