Der Search-Console-Audit bei iEducação begann mit einer Entscheidung: technische Fehler von beabsichtigten Ausschlüssen trennen. Der Bericht zeigte 9.073 nicht indexierte URLs. Das bedeutete jedoch nicht, dass 9.073 Fehler beseitigt werden mussten.
Die Arbeit verknüpfte die Berichte mit der tatsächlichen WordPress-Konfiguration: Indexierung, Weiterleitungen, Paginierung, strukturierte Daten und Komponenten, die das Nutzungserlebnis beeinflussen. Die folgende Reihenfolge erklärt, was umgesetzt wurde und warum die einzelnen Schritte aufeinander aufbauten.
Als Quelle dient der technische Bericht, den der Verantwortliche von iEducação bereitgestellt hat.
1. Den Ausgangszustand vor Änderungen dokumentieren
- Die HTTPS-Property und den Aktualisierungsstand der Berichte bestätigen.
- Beispiele exportieren und die URLs mit dem WordPress-Bestand abgleichen.
- Anweisungen, Sicherungen und Hashwerte vor Konfigurationsänderungen dokumentieren.
Zunächst wurden die richtige HTTPS-Property und der Datenstand geprüft. Der Indexierungsbericht war auf dem Stand vom 23. Oktober, der Core-Web-Vitals-Bericht vom 3. November. Damit ließ sich Googles Verlauf mit den aktuellen Antworten der Website vergleichen.
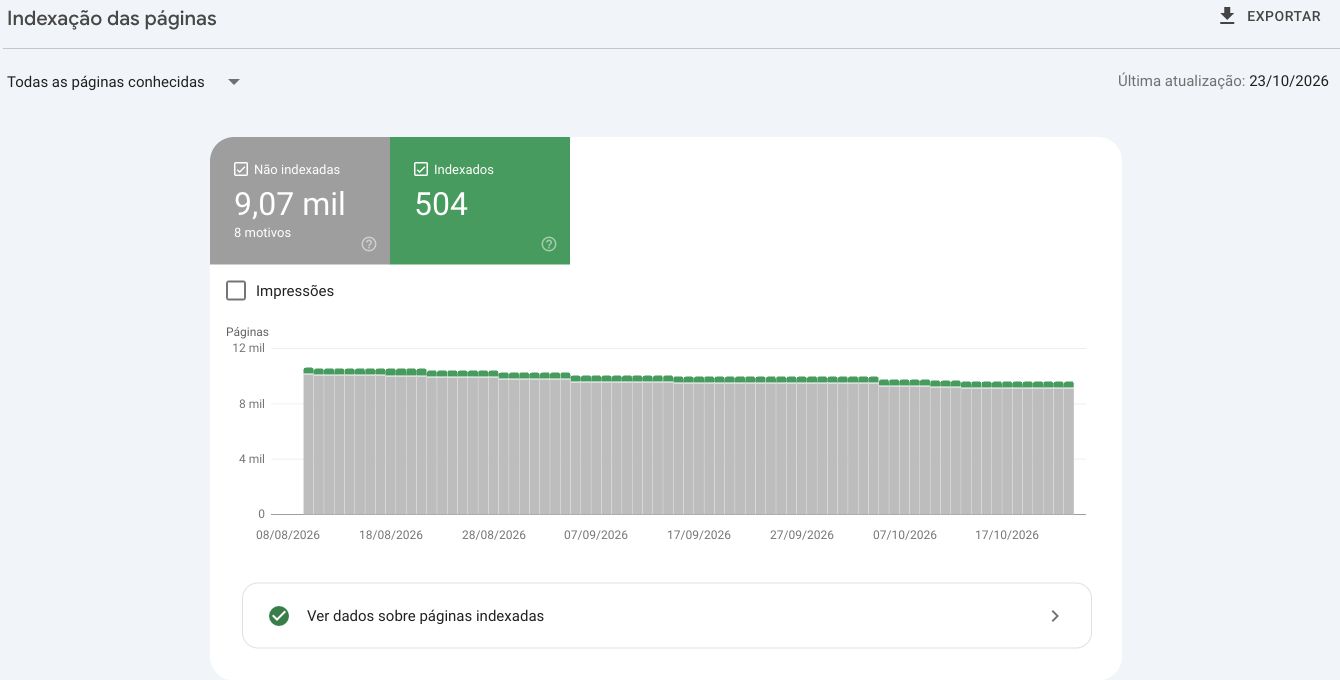
Die verfügbaren Tabellen wurden exportiert und mit dem WordPress-Bestand abgeglichen: 418 Beiträge, 24 Seiten und 293 Inhalte des Typs PDF, insgesamt 735 veröffentlichte Inhalte. Außerdem wurden individuelle Rank-Math-Anweisungen, Kategorien, Sitemaps und gemeinsam genutzte Komponenten erfasst.
Vor den Änderungen wurden Sicherungen erstellt und Hashwerte berechnet. Diese Kennwerte machen Änderungen am Inhalt erkennbar. Bei der Umsetzung wurde der vorherige Zustand verglichen, um gleichzeitige Bearbeitungen zu schützen. Diese Vorbereitung legte den Umfang der Korrekturen und die Möglichkeit eines gezielten Rollbacks fest.
2. Festlegen, was in Google erscheinen soll
Für die Suche geeignete Inhalte
Anschließend wurden die URLs nach ihrem Zweck eingeordnet. Beiträge, Seiten und Kategorien konnten unter Berücksichtigung ihrer individuellen Einstellungen für die Suche geeignet sein. Autorenprofile mit Biografie und Veröffentlichungen behielten ihren redaktionellen Kontext; leere Profile erhielten noindex, um außerhalb der Suchergebnisse zu bleiben.
Beabsichtigte Ausschlüsse
Zugangsseiten zu PDFs, Schlagwörter, interne Suchen und Feeds sollten für Leser zugänglich bleiben, aber nicht im Index stehen. Diese Regel gilt speziell für das Projekt. Auf einer anderen Website können Schlagwortarchive oder Dokumente durchaus indexierungswürdig sein. Entscheidend sind Inhalt und Funktion der jeweiligen Adresse.
Die Gruppe alternativer kanonischer URLs enthielt Adressen, die eine andere Version als bevorzugt angaben. Von den 1.000 exportierbaren Beispielen hatten 999 Parameter. Diese Varianten sollten weiterhin zusammengeführt werden. Eine Paginierung, die den Inhalt tatsächlich änderte, wurde gesondert untersucht.
3. robots.txt und noindex aufeinander abstimmen
Der deutlichste Konflikt betraf 24 indexierte URLs, die durch robots.txt blockiert waren. Es handelte sich um Feeds und interne Suchen. Sie sollten aus der Suche ausgeschlossen werden, doch die Sperre hinderte Google daran, die Antwort abzurufen und noindex zu lesen.
Die Korrektur erlaubte das Crawling dieser öffentlichen Pfade und behielt die Ausschlussanweisung bei, je nach Dokument im Meta-Tag oder HTTP-Header. Robots.txt schränkte das Crawling des Verwaltungsbereichs weiterhin ein, mit der erforderlichen Ausnahme für admin-ajax.php. Öffentliche Bilder blieben crawlbar.
Zudem gab es Unterschiede zwischen der physischen Datei, der Rank-Math-Konfiguration und einer zwischengespeicherten Cloudflare-Kopie. Die Quellen wurden abgeglichen und der Cache dieser URL gezielt geleert. Danach wurde ein erneuter Abruf der robots.txt angefordert.
In WordPress wurde die noindex-Regel für die 293 Inhalte des Typs PDF durchgesetzt. Zwei individuelle Ausnahmen in Rank Math wurden korrigiert. Office-Dokumente und PDFs, die die Website selbst ausliefert, erhielten eine X-Robots-Tag-Regel. Dateien auf Drive unterliegen weiterhin dem ausliefernden Dienst.
1. Crawling erlauben: den öffentlichen Pfad freigeben, den Google lesen muss.
2. noindex ausliefern: das Meta-Tag oder den HTTP-Header der Antwort prüfen.
3. Ausschluss beobachten: erneuten Abruf anfordern und die Verarbeitung in der Search Console verfolgen.
Für die Anwendung auf anderen Websites dient Googles Dokumentation zu noindex als Referenz: Der Crawler muss auf die Seite zugreifen können, um die Anweisung zu lesen. Crawling und Indexierung zu erlauben sind unterschiedliche Entscheidungen.
4. Paginierung korrigieren und gleichwertige Pfade wiederherstellen
In der Sammlung /pdf-gratuito/ verwendet GenerateBlocks den Parameter query-a66c71a4-page, um die angezeigten Materialien zu wechseln. Die zweite Seite hat andere Inhalte als die erste. Deshalb wurde der Canonical-Filter so angepasst, dass er die tatsächliche Abfrage und die Grenzen der Paginierung erkennt.
Eine gültige Seite behält ihre eigene kanonische Adresse. Ein Kampagnenparameter wie utm_source wird aus dem Canonical entfernt, wenn er den Inhalt nicht verändert. Ungültige Werte oder Werte außerhalb des gültigen Bereichs erhalten noindex. Bestehende individuelle Canonical-Einstellungen in Rank Math blieben erhalten.
Für alte Pfade wurden 28 exakte 301-Weiterleitungsregeln angelegt. Die frühere erste Kategorieseite verweist auf die aktuelle Sammlung, die Folgeseiten auf die jeweilige Position. Beispielsweise führt /categoria/pdf-gratuito/page/7/ zu /pdf-gratuito/?query-a66c71a4-page=7.
Alte AMP-Adressen wurden abhängig davon behandelt, ob ein entsprechender veröffentlichter Beitrag oder eine Seite existierte. Entfernte Pfade ohne Entsprechung lieferten weiterhin 404 oder 410. Maßstab war eine tatsächliche Beziehung zwischen Quelle und Ziel, statt alles auf die Startseite weiterzuleiten.
5. Sitemaps und öffentliche Antworten prüfen
Nach Festlegung der Regeln wurde die Sitemap, die URL-Übersicht für Suchmaschinen, mit dem Bestand abgeglichen. Sie enthielt 457 URLs: 418 Beiträge, 25 Einträge in der Seiten-Sitemap einschließlich der Startseite sowie 14 Kategorien. Inhalte des Typs PDF waren ausgeschlossen.
Die öffentliche Prüfung umfasste diese 457 URLs, die 293 PDF-Seiten und 12 weitere Adressen, insgesamt 762 Prüfungen. Die 28 neuen Weiterleitungen wurden separat geprüft. So blieben die Erwartungen an jede Gruppe klar: Zugriff und Eignung, Zugriff mit Ausschluss oder Weiterleitung.
Auch die 66 historischen Beispiele für Serverfehler wurden getestet. Da kein 5xx-Fehler reproduziert wurde, wurde die Validierung dieses konkreten Problems angefordert. Die technische Adresse /wp-*.php, die 403 lieferte, behielt ihren Schutz.
6. Strukturierte Daten mit echten Angaben korrigieren
Im Video-Markup fehlte bei vier Objekten die Adresse des Vorschaubilds, das Feld thumbnailUrl. Zwei weitere hatten Datumsprobleme. Die Metadaten der tatsächlichen YouTube-Videos wurden geprüft. Anschließend erhielten sechs VideoObject-Objekte passende Vorschaubilder, konkrete Titel und die ursprünglichen Datumsangaben im Format ISO 8601 mit Zeitzone.
Verwendet wurde das Datum der ersten Veröffentlichung jedes Videos laut Quelle, nicht der Wartungstag. Das Verfahren folgte Googles Anforderungen an strukturierte Videodaten. Die kommerziellen Seiteninhalte blieben erhalten.
Der separate Bericht zur Videoindexierung wurde nach dem Zweck der Seiten eingeordnet: Die Videos ergänzten Artikel. Es wurden keine künstlichen Wiedergabeseiten angelegt, nur um diesen Indikator zu verändern.
Bei den Kommentaren wurde die frühere Entfernung fehlerhafter Mikrodaten geprüft, wobei die Texte sichtbar blieben. Für die Warnungen wurde eine Validierung angefordert, damit diese Korrektur erneut verarbeitet wird. Außerdem wurde der Mechanismus entfernt, der vermutete sameAs-Entsprechungen zwischen Schlagwörtern und Wikipedia-Seiten erzeugte.
7. Gemeinsam genutzte Anzeigen und JavaScript anpassen
Die Untersuchung des Nutzungserlebnisses konzentrierte sich auf gemeinsam genutzte Komponenten. Die historischen Felddaten zeigten Probleme bei INP, dem Maß für die Reaktion auf Interaktionen, und CLS, dem Maß für visuelle Verschiebungen. Beobachtet wurden spät eingefügte Anzeigen, Höhenänderungen und ein Block, der sich alle zehn Sekunden neu lud.
Das automatische Neuladen wurde entfernt, die erste Anzeige blieb erhalten. Platz für Anzeigen wurde reserviert, und die Navigationsfolge blieb bestehen: erklärender Absatz, Anzeige und Schaltfläche zur PDF-Anforderung. Die native Integration von Ad Inserter übernahm zwei Downloadblöcke in der gemeinsamen Inhaltsverarbeitung und vermied dadurch Duplikate.
Die Platzreservierung erforderte eine Prüfung der Maße nach dem Rendern: AdSense setzte Höhenstile, die eine einfache min-height-Lösung übersteuerten. Gemeinsame Container und responsive Regeln wurden angepasst, ohne Anzeigen auszublenden oder zu beschneiden.
Ein Zwischenschritt mit HTML-Puffer fügte die Downloadanzeige nicht korrekt ein und wurde zurückgenommen. Die endgültige Lösung nutzte die native Funktion adinserter(). Dieser Versuch musste von der finalen Version getrennt bleiben, um die Leistung einer funktional vollständigen Seite zu vergleichen.
Auch die Erkennung des Seitenendes wurde geändert: Wiederholte Prüfungen beim Scrollen wurden durch IntersectionObserver ersetzt. Das vorhandene Ereignis, seine einmalige Ausführung und ein Fallback mit passivem Listener blieben erhalten. Die Anpassungen liegen in den gemeinsam genutzten Dateien des Child-Themes.
8. Umsetzung prüfen und Validierungen in der Search Console starten
- Seiten abgemeldet öffnen und HTML sowie HTTP-Header prüfen.
- Canonical und noindex mit den Regeln für den jeweiligen URL-Typ vergleichen.
- Anzeigen, Schaltflächen und Paginierung am Desktop und auf Mobilgeräten prüfen.
- Abschließende Messungen dokumentieren und die Validierung behobener Probleme anfordern.
Bei iEducação umfasste diese Prüfung Desktop und eine mobile Breite von 390 px. Der WordPress-Cache wurde geleert, ebenso gezielt die Cloudflare-Cache-Einträge für geänderte Ressourcen.
Die abschließenden PageSpeed-Messungen wurden für den Artikel zu Alphabetbuchstaben und die Kategorie Educação Infantil dokumentiert, mobil und am Desktop. Der Zwischentest mit unvollständiger Anzeige blieb im Verlauf gekennzeichnet und vom abschließenden Vergleich getrennt.
Zum Schluss wurden 11 Validierungen gestartet: zwei zur Indexierung, drei zu strukturierten Videodaten, zwei zu Kommentarwarnungen und vier Core-Web-Vitals-Gruppen. Der erneute Abruf der robots.txt wurde separat erfasst. Einzelne Indexierungsanträge wurden bei diesem Eingriff nicht gestellt.
Was geprüft wurde und was jetzt zu beobachten ist
762 URLs geprüft: alle lieferten bei der dokumentierten Prüfung HTTP 200.
293 PDF-Seiten: alle mit noindex gemäß den festgelegten Regeln.
28 Weiterleitungen: 301-Antworten auf gleichwertige Ziele.
Laut technischem Bericht wurden diese Kennzahlen nach Abschluss der Umsetzung geprüft. Keine Sitemap-URL hatte ein unbeabsichtigtes noindex. Die Hashwerte der 735 veröffentlichten Inhalte blieben identisch.
Das sind Ergebnisse der Umsetzung und Prüfung. Die 11 Validierungen wurden gestartet, waren zum dokumentierten Abschluss aber noch nicht bestätigt. Die Search Console zeigte weiterhin historische Core-Web-Vitals-Daten, die von neuen Besuchen und der Verarbeitung der Felddaten abhängen.
Im mobilen Buchstabentest lag der Leistungswert vorher und nachher bei 99. Der Labor-CLS war in beiden Durchläufen bereits null. Der Speed Index stieg in der abschließenden Messung von 2,925 s auf 3,206 s. Der Vergleich belegt daher weder eine Verringerung des historischen CLS noch eine allgemeine Geschwindigkeitsverbesserung. Auch die abschließenden Barrierefreiheitswerte von 90 und 92 für die getesteten Seiten enthielten weiter Warnungen.
Die weitere Beobachtung sollte das Ergebnis jeder Validierung, den konsistenten Ausschluss von Feeds und Suchen, die Stimmigkeit der Sitemaps sowie die Entwicklung von INP und CLS in Felddaten prüfen. Verkehrsvergleiche erfordern gleichwertige Zeiträume und müssen Suchanfragen, Seiten und die brasilianische Schulsaisonalität berücksichtigen.
Es gibt noch keine späteren Messungen, die eine Erholung bei Klicks, Verkäufen oder Umsatz belegen. Der Eingriff schuf eine technische Grundlage für diese Beobachtung. Die historische Analyse des organischen Traffics und der Verkäufe von iEducação betrifft einen anderen Zeitraum und darf nicht als Ergebnis dieser Korrekturen verwendet werden.
Methode und Grenzen: Dieser Artikel fasst den vom Verantwortlichen bereitgestellten Eingriffsbericht zusammen. KI unterstützte die Gliederung und Formulierung. Die internen Gesamtzahlen werden diesem Dokument zugeschrieben; die vollständige URL-Prüfung wurde hier nicht wiederholt. Bei den größeren Ausschlussgruppen waren höchstens 1.000 Beispiele exportierbar. Labor- und Layoutprüfungen gelten für die beschriebenen Seiten und Bedingungen.
Mehr zum Unterschied zwischen Test und tatsächlicher Nutzung steht in Hoher PageSpeed-Wert und langsame Website: was vor der Optimierung zu prüfen ist. Technische Referenzen sind die Dokumentation zur Seitenindexierung, zu noindex, strukturierten Videodaten, Core Web Vitals und zur CLS-Optimierung.
Sie möchten eine solche technische Korrektur für Ihre WordPress-Website organisieren? Sprechen wir auf WhatsApp darüber.