L’audit di Search Console su iEducação è iniziato con una decisione: distinguere gli errori tecnici dalle esclusioni intenzionali. Il rapporto mostrava 9.073 URL non indicizzati, ma questa cifra non corrispondeva a 9.073 errori da eliminare.
Il lavoro ha collegato la lettura dei rapporti alla configurazione reale di WordPress: indicizzazione, reindirizzamenti, paginazione, dati strutturati e componenti che influiscono sull’esperienza di navigazione. La sequenza seguente spiega cosa è stato fatto e perché ogni passaggio precedeva il successivo.
La fonte è il rapporto tecnico fornito dal responsabile di iEducação.
1. Documentare la situazione prima di modificare il sito
- Confermare la proprietà HTTPS e le date di aggiornamento dei rapporti.
- Esportare gli esempi e confrontare gli URL con l’inventario di WordPress.
- Registrare direttive, backup e hash prima di modificare le impostazioni.
Il primo passaggio è stato verificare la proprietà HTTPS corretta e la data dei dati. Il rapporto di indicizzazione era aggiornato al 23 ottobre; quello sui Core Web Vitals, al 3 novembre. Questo riferimento ha permesso di confrontare lo storico di Google con le risposte attuali del sito.
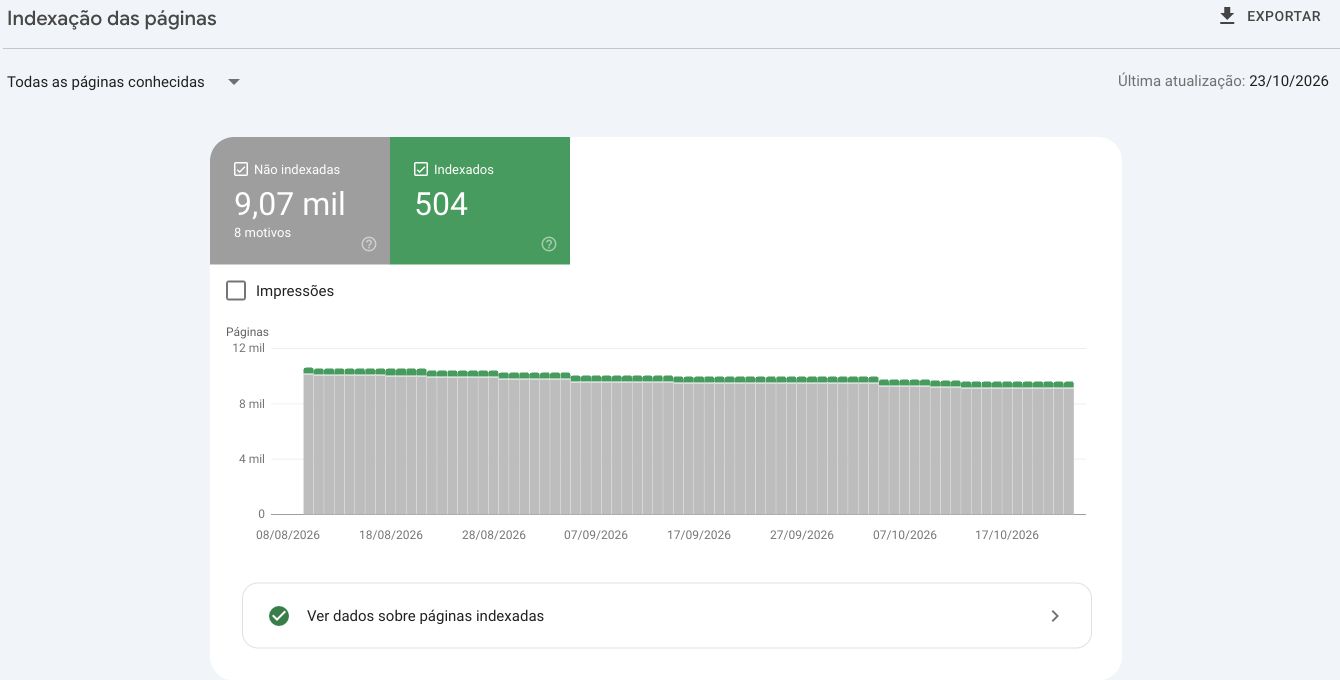
Le tabelle disponibili sono state esportate e confrontate con l’inventario WordPress: 418 articoli, 24 pagine e 293 contenuti di tipo PDF, per un totale di 735 contenuti pubblicati. Sono state inoltre rilevate le direttive individuali di Rank Math, le categorie, le sitemap e i componenti condivisi.
Prima delle modifiche sono stati creati backup e calcolati hash, identificatori che consentono di rilevare variazioni nei contenuti. L’implementazione ha confrontato lo stato precedente per proteggere le modifiche simultanee. Questa preparazione ha definito l’ambito delle correzioni e la possibilità di un ripristino mirato.
2. Definire cosa doveva apparire su Google
Contenuti idonei alla ricerca
Gli URL sono stati poi classificati in base alla loro funzione. Articoli, pagine e categorie potevano essere idonei alla ricerca, nel rispetto delle impostazioni individuali. I profili autore con biografia e pubblicazioni hanno mantenuto il proprio contesto editoriale; quelli vuoti hanno ricevuto la direttiva noindex per restare fuori dai risultati.
Esclusioni intenzionali
Le pagine di accesso ai PDF, i tag, le ricerche interne e i feed dovevano restare accessibili ai lettori, ma fuori dall’indice. È una politica specifica del progetto. Un altro sito può avere archivi di tag o documenti che meritano l’indicizzazione; la decisione dipende dal contenuto e dalla funzione di ogni indirizzo.
Il gruppo delle alternative canoniche comprendeva URL che indicavano un’altra versione come preferita. Dei 1.000 esempi esportabili, 999 avevano parametri. Si è deciso di conservare il consolidamento di queste varianti e di esaminare separatamente la paginazione che modificava davvero il contenuto.
3. Allineare robots.txt e noindex
Il conflitto più diretto riguardava 24 URL indicizzati e bloccati da robots.txt. Erano feed e ricerche interne. Si intendeva escluderli dalla ricerca, ma il blocco impediva a Google di accedere alla risposta e leggere il noindex.
La correzione ha consentito la scansione di questi percorsi pubblici, mantenendo la direttiva di esclusione nel meta tag o nell’intestazione HTTP, a seconda del documento. Robots.txt ha continuato a limitare la scansione dell’area amministrativa, con l’eccezione necessaria per admin-ajax.php. Le immagini pubbliche sono rimaste accessibili alla scansione.
Esistevano anche differenze tra il file fisico, la configurazione di Rank Math e una copia nella cache di Cloudflare. Le fonti sono state allineate e la cache dell’URL è stata invalidata in modo selettivo. È stata poi richiesta una nuova lettura di robots.txt.
In WordPress è stata rafforzata la politica noindex per i 293 contenuti di tipo PDF. Sono state corrette due eccezioni individuali di Rank Math. I documenti Office e i PDF serviti dal sito hanno ricevuto una regola X-Robots-Tag; i file ospitati su Drive restano soggetti al servizio che li distribuisce.
1. Consentire la scansione: sbloccare il percorso pubblico che Google deve leggere.
2. Fornire il noindex: verificare il meta tag o l’intestazione HTTP della risposta.
3. Monitorare l’esclusione: richiedere una nuova lettura e osservare l’elaborazione in Search Console.
Per applicare la procedura a un altro sito, il riferimento è la documentazione di Google su noindex: il crawler deve poter accedere alla pagina per leggere la direttiva. Consentire la scansione e consentire l’indicizzazione sono decisioni diverse.
4. Correggere la paginazione e ripristinare percorsi equivalenti
Nella raccolta /pdf-gratuito/, GenerateBlocks utilizza il parametro query-a66c71a4-page per cambiare i materiali visualizzati. La seconda pagina contiene materiali diversi dalla prima. Il filtro canonical è stato quindi adattato per riconoscere la query reale e i limiti della paginazione.
Una pagina valida conserva il proprio indirizzo canonico. Un parametro di campagna, come utm_source, viene rimosso dal canonical quando non cambia il contenuto. I valori non validi o fuori intervallo ricevono noindex. Le impostazioni canoniche individuali già presenti in Rank Math sono state conservate.
Per i vecchi percorsi sono state create 28 regole esatte di reindirizzamento 301. La vecchia pagina 1 della categoria rimanda alla raccolta attuale; le successive, alla posizione corrispondente. Per esempio, /categoria/pdf-gratuito/page/7/ porta a /pdf-gratuito/?query-a66c71a4-page=7.
I vecchi indirizzi AMP sono stati trattati in base all’esistenza di un articolo o di una pagina pubblicata equivalente. I percorsi rimossi senza equivalente hanno continuato a restituire 404 o 410. Il criterio è stato ripristinare una relazione reale tra origine e destinazione, evitando di reindirizzare tutto alla pagina iniziale.
5. Verificare sitemap e risposte pubbliche
Definita la politica, la sitemap, la mappa di URL fornita ai motori di ricerca, è stata confrontata con l’inventario. Comprendeva 457 URL: 418 articoli, 25 voci nella sitemap delle pagine, inclusa la pagina iniziale, e 14 categorie. I contenuti di tipo PDF sono rimasti esclusi.
La verifica pubblica ha coperto questi 457 URL, le 293 pagine di PDF e 12 indirizzi aggiuntivi, per un totale di 762 verifiche. I 28 nuovi reindirizzamenti sono stati controllati separatamente. Questa distinzione ha chiarito le aspettative per ogni gruppo: accesso e idoneità, accesso con esclusione oppure reindirizzamento.
Sono stati testati anche i 66 esempi storici di errore del server. Poiché nessun errore 5xx è stato riprodotto, è stata richiesta la convalida di quel problema specifico. L’indirizzo tecnico /wp-*.php, che rispondeva 403, ha mantenuto la propria protezione.
6. Correggere i dati strutturati con informazioni reali
Nel markup video, quattro oggetti non indicavano l’indirizzo della miniatura, il campo thumbnailUrl, e due presentavano problemi di data. Sono stati verificati i metadati dei video reali su YouTube e sei oggetti VideoObject hanno ricevuto miniature corrispondenti, titoli specifici e date originali in formato ISO 8601 con fuso orario.
La data utilizzata è stata quella della prima pubblicazione di ogni video, secondo la fonte, anziché il giorno della manutenzione. La procedura ha seguito i requisiti di Google per i dati strutturati video. Il contenuto commerciale delle pagine è stato conservato.
Il rapporto separato di indicizzazione video è stato interpretato in base alla funzione delle pagine: i video completavano gli articoli. Non sono state create pagine di visualizzazione artificiali solo per modificare questo indicatore.
Per i commenti è stata verificata la precedente rimozione di microdati impropri, mantenendo visibili i testi. Sono state richieste le convalide degli avvisi per rielaborare questa correzione. È stato inoltre rimosso il meccanismo che creava equivalenze sameAs presunte tra tag e pagine di Wikipedia.
7. Adeguare annunci e JavaScript condivisi
L’indagine sull’esperienza si è concentrata sui componenti comuni. Lo storico dei dati sul campo segnalava problemi di INP, che misura la reattività alle interazioni, e CLS, che misura gli spostamenti visivi. Sono stati osservati inserimenti tardivi di annunci, variazioni di altezza e un blocco che si ricaricava ogni dieci secondi.
Il ricaricamento automatico è stato eliminato, conservando la visualizzazione iniziale. Sono stati riservati spazi per gli annunci ed è stata mantenuta la sequenza di navigazione: paragrafo contestuale, annuncio e pulsante di richiesta del PDF. L’integrazione nativa di Ad Inserter ha assunto il controllo di due blocchi di download nell’elaborazione condivisa del contenuto, evitando duplicazioni.
La riserva di spazio ha richiesto il controllo delle dimensioni dopo il rendering: AdSense applicava stili di altezza che annullavano una semplice soluzione con min-height. Sono stati adeguati i contenitori comuni e le regole responsive, senza nascondere o ritagliare gli annunci.
Un tentativo intermedio con buffer HTML non inseriva correttamente l’annuncio di download ed è stato annullato. La soluzione finale ha utilizzato la funzione nativa adinserter(). Distinguere quel tentativo dalla versione finale era necessario per confrontare le prestazioni di una pagina con tutte le funzioni operative.
È cambiato anche il rilevamento dell’arrivo al piè di pagina: i controlli ripetuti durante lo scorrimento sono stati sostituiti con IntersectionObserver, conservando l’evento esistente, la sua esecuzione unica e un fallback con listener passivo. Gli adeguamenti sono rimasti nei file condivisi del tema child.
8. Verificare la consegna e avviare le convalide in Search Console
- Aprire le pagine senza autenticazione e controllare HTML e intestazioni HTTP.
- Confrontare canonical e noindex con la politica di ogni tipo di URL.
- Controllare annunci, pulsanti e paginazione su computer e dispositivi mobili.
- Registrare le misurazioni finali e richiedere la convalida dei problemi corretti.
Nell’intervento su iEducação, la verifica ha incluso il computer e una larghezza mobile di 390 px. È stata svuotata la cache di WordPress e, in modo selettivo, quella delle risorse modificate su Cloudflare.
Le misurazioni finali di PageSpeed sono state registrate per l’articolo sulle lettere dell’alfabeto e la categoria Educação Infantil, su mobile e computer. Il test intermedio con annuncio incompleto è rimasto identificato nello storico, separato dal confronto finale.
Infine sono state avviate 11 convalide: due di indicizzazione, tre per i dati strutturati video, due per gli avvisi dei commenti e quattro gruppi di Core Web Vitals. La richiesta di nuova lettura di robots.txt è stata registrata separatamente. Durante l’intervento non sono state presentate richieste individuali di indicizzazione.
Cosa è stato verificato e cosa monitorare ora
762 URL verificati: tutti hanno risposto HTTP 200 nel controllo documentato.
293 pagine di PDF: tutte con noindex, secondo la politica definita.
28 reindirizzamenti: risposte 301 verso destinazioni equivalenti.
Secondo il rapporto tecnico, questi indicatori sono stati verificati al termine dell’implementazione. Nessun URL delle sitemap presentava un noindex improprio e gli hash dei 735 contenuti pubblicati sono rimasti identici.
Sono risultati di implementazione e verifica. Le 11 convalide sono state avviate, ma non erano ancora approvate alla chiusura documentata. Search Console continuava a mostrare lo storico dei Core Web Vitals, che dipende da nuove visite e dall’elaborazione dei dati sul campo.
Nel test mobile delle lettere, il punteggio delle prestazioni era 99 prima e dopo. Il CLS di laboratorio era già zero in entrambi i test. Lo Speed Index è passato da 2,925 s a 3,206 s nella misurazione finale. Il confronto non dimostra quindi una riduzione del CLS storico né un miglioramento generale della velocità. Anche i punteggi finali di accessibilità, 90 e 92 sulle pagine testate, mantenevano degli avvisi.
Il monitoraggio deve verificare l’esito di ogni convalida, l’esclusione coerente di feed e ricerche, la coerenza delle sitemap e l’andamento di INP e CLS sul campo. Per il traffico, il confronto deve usare periodi equivalenti e considerare query, pagine e stagionalità scolastica brasiliana.
Non ci sono ancora misurazioni successive che dimostrino un recupero di clic, vendite o ricavi. L’intervento ha creato una base tecnica per questo monitoraggio. L’analisi storica del traffico organico e delle vendite di iEducação riguarda un altro periodo e non va usata come risultato di queste correzioni.
Metodo e limiti: questo articolo sintetizza il rapporto dell’intervento fornito dal responsabile, con il supporto dell’IA nell’organizzazione e nella scrittura. I totali interni sono attribuiti a quel documento; qui non è stato ripetuto l’audit di tutti gli URL. I gruppi maggiori di esclusione avevano un limite di 1.000 esempi esportabili. Le verifiche di laboratorio e di layout coprono le pagine e le condizioni descritte.
Per approfondire la differenza tra test ed esperienza reale, leggi anche PageSpeed alto e sito lento: cosa verificare prima di ottimizzare. I riferimenti tecnici comprendono la documentazione su indicizzazione delle pagine, noindex, dati strutturati video, Core Web Vitals e ottimizzazione del CLS.
Devi organizzare una correzione tecnica di questo tipo sul tuo WordPress? Parliamone su WhatsApp.