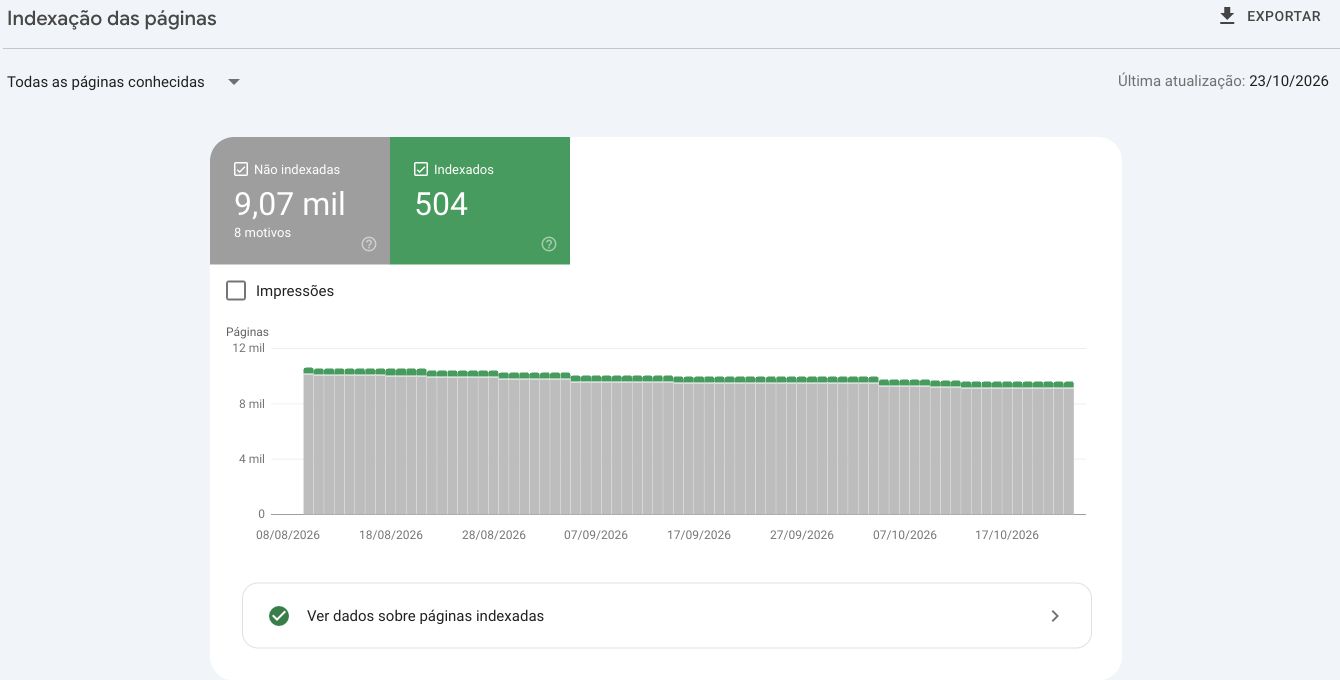
A auditoria do Search Console no iEducação começou por uma decisão: separar falhas técnicas de exclusões intencionais. Havia 9.073 URLs não indexadas no relatório, mas esse número não representava 9.073 erros a eliminar.
O trabalho conectou a leitura dos relatórios à configuração real do WordPress: indexação, redirecionamentos, paginação, dados estruturados e componentes que afetam a experiência de navegação. A sequência abaixo explica o que foi feito e por que cada etapa veio antes da seguinte.
A fonte é o relatório técnico fornecido pelo responsável pelo iEducação.
1. Registrar o cenário antes de alterar o site
- Confirmar a propriedade HTTPS e a data de atualização dos relatórios.
- Exportar os exemplos e cruzar as URLs com o inventário do WordPress.
- Registrar diretivas, backups e hashes antes de alterar configurações.
O primeiro passo foi conferir a propriedade HTTPS correta e a data dos dados. O relatório de indexação tinha atualização de 23 de outubro; o de Core Web Vitals, de 3 de novembro. Essa referência permitiu comparar o histórico do Google com as respostas atuais do site.
As tabelas disponíveis foram exportadas e cruzadas com o inventário do WordPress: 418 posts, 24 páginas e 293 conteúdos do tipo PDF, totalizando 735 conteúdos publicados. Também foram levantadas diretivas individuais do Rank Math, categorias, sitemaps e componentes compartilhados.
Antes das alterações, foram feitos backups e calculados hashes, identificadores que permitem detectar mudanças no conteúdo. A implantação comparou o estado anterior para proteger edições concorrentes. Essa preparação definiu tanto o alcance das correções quanto uma possibilidade de reversão pontual.
2. Definir o que deveria aparecer no Google
Elegíveis à busca
Em seguida, as URLs foram classificadas pelo propósito. Posts, páginas e categorias poderiam ser elegíveis à busca, respeitando as configurações individuais. Autores com biografia e publicações mantiveram contexto editorial; perfis vazios receberam a instrução noindex para ficar fora dos resultados de busca.
Exclusões intencionais
Páginas de acesso a PDFs, tags, buscas internas e feeds deveriam continuar acessíveis aos leitores, mas fora do índice. Essa é uma política específica do projeto. Outro site pode ter arquivos de tags ou documentos que mereçam indexação; a decisão depende do conteúdo e da função de cada endereço.
O grupo de alternativas canônicas reunia URLs que indicavam outra versão como preferida. Entre os 1.000 exemplos exportáveis, 999 tinham parâmetros. A decisão foi preservar a consolidação dessas variantes e investigar separadamente a paginação que realmente mudava o conteúdo.
3. Alinhar robots.txt e noindex
O conflito mais direto envolvia 24 URLs indexadas e bloqueadas pelo robots.txt. Eram feeds e buscas internas. A intenção era excluí-las da pesquisa, mas o bloqueio impedia o Google de acessar a resposta e ler o noindex.
A correção foi permitir o rastreamento dessas rotas públicas e manter a instrução de exclusão, na meta tag ou no cabeçalho HTTP conforme o documento. O robots.txt continuou restringindo o rastreamento da área administrativa, com a exceção necessária para admin-ajax.php. As imagens públicas permaneceram rastreáveis.
Também havia divergência entre o arquivo físico, a configuração do Rank Math e uma cópia em cache no Cloudflare. As fontes foram alinhadas e o cache da URL foi invalidado seletivamente. Depois, foi solicitada a releitura do robots.txt.
No WordPress, a política de noindex foi reforçada para os 293 conteúdos do tipo PDF. Duas exceções individuais do Rank Math foram corrigidas. Documentos de escritório e PDFs servidos pelo próprio site receberam uma regra de X-Robots-Tag; arquivos hospedados no Drive continuam sujeitos ao serviço que os entrega.
1. Permitir rastreamento: liberar a rota pública que precisa ser lida pelo Google.
2. Entregar o noindex: conferir a meta tag ou o cabeçalho HTTP na resposta.
3. Acompanhar a exclusão: pedir a releitura e observar o processamento no Search Console.
Para aplicar esse procedimento em outro site, a referência é a documentação do Google sobre noindex: o rastreador precisa conseguir acessar a página para ler a diretiva. Permitir rastreamento e permitir indexação são decisões diferentes.
4. Corrigir a paginação e recuperar caminhos equivalentes
No acervo /pdf-gratuito/, o GenerateBlocks utiliza o parâmetro query-a66c71a4-page para trocar os materiais exibidos. A segunda página tem conteúdo diferente da primeira. Por isso, o filtro de canonical passou a reconhecer a consulta real e os limites da paginação.
Uma página válida preserva seu próprio endereço canônico. Um parâmetro de campanha, como utm_source, é retirado do canonical quando não muda o conteúdo. Valores inválidos ou fora do alcance recebem noindex. As configurações canônicas individuais existentes no Rank Math foram preservadas.
Para os caminhos antigos, foram criadas 28 regras exatas de redirecionamento 301. A antiga página 1 da categoria aponta para o acervo atual; as páginas seguintes apontam para a posição correspondente. Por exemplo, /categoria/pdf-gratuito/page/7/ leva a /pdf-gratuito/?query-a66c71a4-page=7.
Os endereços AMP legados receberam tratamento condicionado à existência de um post ou página publicado correspondente. Rotas removidas sem equivalente continuaram com 404 ou 410. O critério foi recuperar uma relação real entre origem e destino, evitando redirecionar tudo para a página inicial.
5. Conferir sitemaps e respostas públicas
Com a política definida, o sitemap, mapa de URLs fornecido aos buscadores, foi conferido contra o inventário. Ele reunia 457 URLs: 418 posts, 25 entradas no sitemap de páginas, incluindo a inicial, e 14 categorias. Os conteúdos do tipo PDF ficaram fora dessa relação.
A verificação pública cobriu essas 457 URLs, as 293 páginas de PDF e 12 endereços adicionais, totalizando 762 verificações. Os 28 redirecionamentos novos tiveram uma conferência separada. Essa divisão manteve claras as expectativas para cada grupo: acesso e elegibilidade, acesso com exclusão ou encaminhamento.
Os 66 exemplos históricos de erro de servidor também foram testados. Como nenhum 5xx foi reproduzido, foi solicitada a validação desse problema específico. O endereço técnico /wp-*.php, que respondia 403, manteve sua proteção.
6. Corrigir os dados estruturados com informações reais
Na marcação de vídeo, quatro objetos não informavam o endereço da miniatura, campo thumbnailUrl, e dois apresentavam problemas de data. Os metadados dos vídeos reais do YouTube foram conferidos, e seis objetos VideoObject receberam miniaturas correspondentes, títulos específicos e datas originais em formato ISO 8601 com fuso.
A data usada foi a primeira publicação de cada vídeo, conforme a fonte, e não o dia da manutenção. O procedimento seguiu os requisitos de dados estruturados de vídeo do Google. O conteúdo comercial das páginas foi preservado.
O relatório separado de indexação de vídeos foi interpretado pelo propósito das páginas: os vídeos complementavam artigos. Não foram criadas páginas de exibição artificiais apenas para alterar esse indicador.
Nos comentários, foi conferida a remoção anterior da microdata indevida, mantendo os textos visíveis. As validações dos avisos foram solicitadas para reprocessar essa correção. Também foi retirado o mecanismo que criava equivalências sameAs presumidas entre tags e páginas da Wikipedia.
7. Ajustar anúncios e JavaScript compartilhados
A investigação de experiência se concentrou nos componentes comuns. O histórico de campo apontava problemas de INP, que mede resposta à interação, e CLS, que mede deslocamentos visuais. Foram observadas inserções tardias de anúncios, mudanças de altura e um bloco com recarregamento a cada dez segundos.
O recarregamento automático foi retirado, preservando a exibição inicial. Foram reservados espaços para os anúncios e mantida a sequência de navegação: parágrafo contextual, anúncio e botão de solicitação do PDF. A integração nativa do Ad Inserter passou a controlar dois blocos de download no processamento compartilhado do conteúdo, evitando duplicações.
A reserva exigiu conferir as dimensões após a renderização: o AdSense aplicava estilos de altura que anulavam uma solução simples com min-height. Foram ajustados os contêineres comuns e as regras responsivas, sem esconder ou recortar anúncios.
Uma tentativa intermediária com buffer HTML não inseriu corretamente o anúncio de download e foi revertida. A solução final usou a função nativa adinserter(). Separar essa tentativa da versão final foi necessário para comparar o desempenho de uma página funcionalmente completa.
O detector de chegada ao rodapé também mudou: a leitura repetida durante o scroll foi substituída por IntersectionObserver, preservando o evento existente, sua execução única e um fallback com listener passivo. Os ajustes ficaram nos arquivos compartilhados do tema filho.
8. Verificar a entrega e iniciar validações no Search Console
- Abrir as páginas sem login e conferir o HTML e os cabeçalhos HTTP.
- Comparar canonical e noindex com a política de cada tipo de URL.
- Conferir anúncios, botões e paginação no computador e no celular.
- Registrar as medições finais e solicitar a validação dos problemas corrigidos.
Na intervenção do iEducação, essa conferência incluiu o computador e uma largura móvel de 390 px. O cache foi limpo no WordPress e seletivamente nos recursos alterados do Cloudflare.
As medições finais de PageSpeed foram registradas para o artigo de letras do alfabeto e a categoria Educação Infantil, no celular e no computador. A rodada intermediária com anúncio incompleto permaneceu identificada no histórico, separada da comparação final.
Por fim, foram iniciadas 11 validações: duas de indexação, três de dados estruturados de vídeo, duas dos avisos de comentários e quatro grupos de Core Web Vitals. A solicitação de releitura do robots.txt foi registrada separadamente. Não houve pedidos individuais de indexação nesta intervenção.
O que foi verificado e o que acompanhar agora
762 URLs verificadas: todas responderam HTTP 200 na checagem documentada.
293 páginas de PDF: todas com noindex, conforme a política definida.
28 redirecionamentos: respostas 301 para destinos equivalentes.
Segundo o relatório técnico, os indicadores acima foram conferidos ao final da implantação. Nenhuma URL dos sitemaps apresentou noindex indevido, e os hashes dos 735 conteúdos publicados permaneceram idênticos.
Esses são resultados de implantação e verificação. As 11 validações foram iniciadas, mas ainda não estavam aprovadas no encerramento documentado. O Search Console continuava exibindo o histórico de Core Web Vitals, que depende de novas visitas e do processamento dos dados de campo.
No teste móvel de letras, a nota de desempenho foi 99 antes e depois. O CLS de laboratório já era zero nas duas rodadas. O Speed Index passou de 2,925 s para 3,206 s na medição final. Portanto, a comparação não demonstra redução do CLS histórico nem uma melhora geral de velocidade. As notas finais de acessibilidade, 90 e 92 nas páginas testadas, também mantinham avisos.
O acompanhamento deve conferir o resultado de cada validação, a exclusão coerente de feeds e buscas, a consistência dos sitemaps e a evolução de INP e CLS em campo. Para tráfego, a comparação precisa usar janelas equivalentes e considerar consultas, páginas e sazonalidade escolar brasileira.
Ainda não há medição posterior que comprove recuperação de cliques, vendas ou receita. A intervenção criou uma base técnica para esse acompanhamento. A análise histórica de tráfego orgânico e vendas do iEducação trata de outro período e não deve ser usada como resultado destas correções.
Método e limites: este artigo sintetiza o relatório da intervenção, fornecido pelo responsável, com apoio de IA na organização e redação. Os totais internos são atribuídos a esse documento; não foi repetida aqui a auditoria de todas as URLs. Os grupos maiores de exclusão tinham limite de 1.000 exemplos exportáveis. As verificações de laboratório e de layout cobrem as páginas e condições descritas.
Para aprofundar a diferença entre teste e experiência real, leia também PageSpeed alto e site lento: o que verificar antes de otimizar. As referências técnicas utilizadas incluem a documentação de indexação de páginas, noindex, dados estruturados de vídeo, Core Web Vitals e otimização de CLS.
Precisa organizar uma correção técnica desse tipo no seu WordPress? Converse comigo pelo WhatsApp.