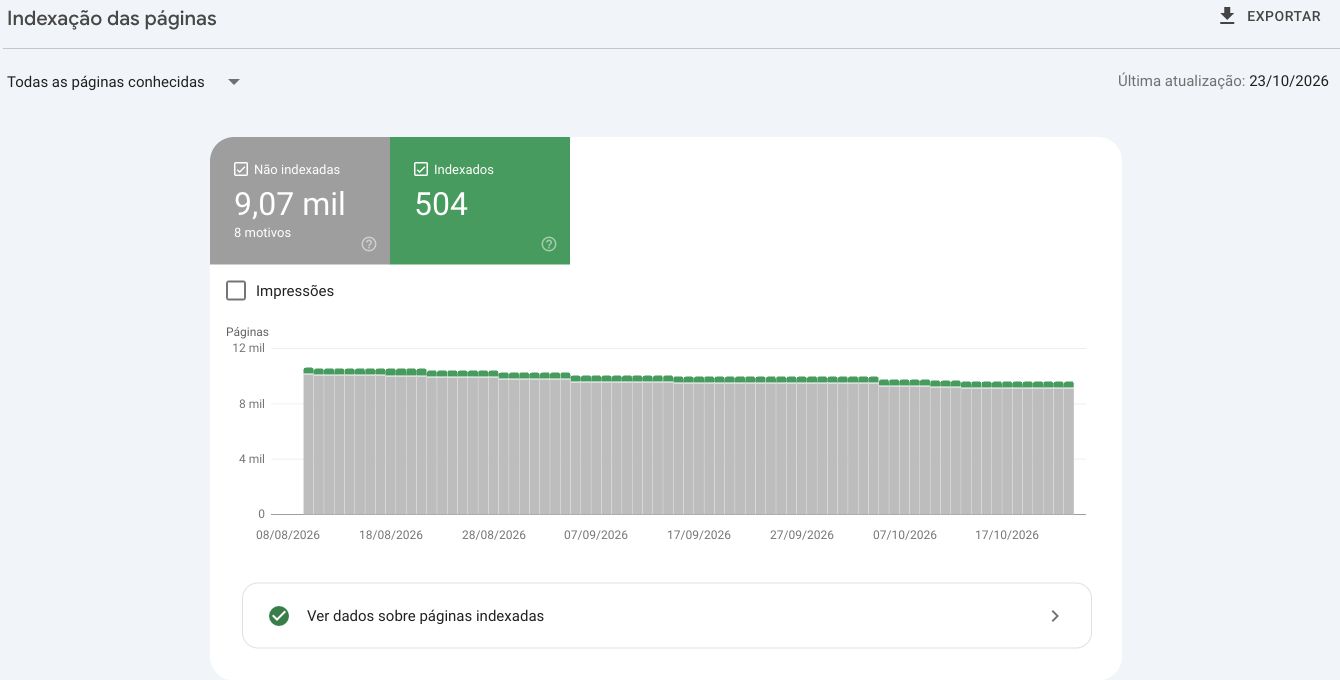
La auditoría de Search Console en iEducação comenzó con una decisión: separar los fallos técnicos de las exclusiones intencionadas. El informe mostraba 9.073 URLs no indexadas, pero esa cifra no representaba 9.073 errores que hubiera que eliminar.
El trabajo conectó la lectura de los informes con la configuración real de WordPress: indexación, redirecciones, paginación, datos estructurados y componentes que afectan a la experiencia de navegación. La secuencia siguiente explica qué se hizo y por qué cada paso precedió al siguiente.
La fuente es el informe técnico facilitado por el responsable de iEducação.
1. Registrar la situación antes de modificar el sitio
- Confirmar la propiedad HTTPS y la fecha de actualización de los informes.
- Exportar los ejemplos y contrastar las URLs con el inventario de WordPress.
- Registrar directivas, copias de seguridad y hashes antes de cambiar la configuración.
El primer paso fue comprobar la propiedad HTTPS correcta y la fecha de los datos. El informe de indexación estaba actualizado al 23 de octubre; el de Core Web Vitals, al 3 de noviembre. Esta referencia permitió comparar el historial de Google con las respuestas actuales del sitio.
Las tablas disponibles se exportaron y se contrastaron con el inventario de WordPress: 418 entradas, 24 páginas y 293 contenidos del tipo PDF, un total de 735 contenidos publicados. También se revisaron las directivas individuales de Rank Math, las categorías, los sitemaps y los componentes compartidos.
Antes de los cambios se hicieron copias de seguridad y se calcularon hashes, identificadores que permiten detectar modificaciones en el contenido. Durante la implantación se comparó el estado anterior para proteger las ediciones simultáneas. Esta preparación delimitó las correcciones y permitió prever una reversión puntual.
2. Definir qué debía aparecer en Google
Contenido apto para la búsqueda
Después se clasificaron las URLs según su función. Las entradas, páginas y categorías podían ser aptas para la búsqueda, respetando su configuración individual. Los autores con biografía y publicaciones conservaron su contexto editorial; los perfiles vacíos recibieron la directiva noindex para quedar fuera de los resultados.
Exclusiones intencionadas
Las páginas de acceso a PDF, las etiquetas, las búsquedas internas y los feeds debían seguir siendo accesibles para los lectores, pero quedar fuera del índice. Es una política específica del proyecto. En otro sitio, los archivos de etiquetas o los documentos pueden merecer indexación; la decisión depende del contenido y de la función de cada dirección.
El grupo de alternativas canónicas reunía URLs que señalaban otra versión como preferida. De los 1.000 ejemplos exportables, 999 tenían parámetros. Se decidió conservar la consolidación de esas variantes e investigar por separado la paginación que realmente cambiaba el contenido.
3. Alinear robots.txt y noindex
El conflicto más directo afectaba a 24 URLs indexadas y bloqueadas por robots.txt. Eran feeds y búsquedas internas. Se pretendía excluirlas de la búsqueda, pero el bloqueo impedía que Google accediera a la respuesta y leyera el noindex.
La corrección consistió en permitir el rastreo de esas rutas públicas y mantener la directiva de exclusión, en la metaetiqueta o en la cabecera HTTP según el documento. Robots.txt siguió restringiendo el rastreo de la zona administrativa, con la excepción necesaria para admin-ajax.php. Las imágenes públicas siguieron siendo rastreables.
También había diferencias entre el archivo físico, la configuración de Rank Math y una copia almacenada en la caché de Cloudflare. Se unificaron las fuentes y se invalidó selectivamente la caché de esa URL. Después se solicitó una nueva lectura de robots.txt.
En WordPress se reforzó la política noindex para los 293 contenidos del tipo PDF. Se corrigieron dos excepciones individuales de Rank Math. Los documentos de oficina y los PDF servidos por el propio sitio recibieron una regla X-Robots-Tag; los archivos alojados en Drive siguen sujetos al servicio que los entrega.
1. Permitir el rastreo: habilitar la ruta pública que Google necesita leer.
2. Entregar el noindex: comprobar la metaetiqueta o la cabecera HTTP de la respuesta.
3. Seguir la exclusión: solicitar una nueva lectura y observar el procesamiento en Search Console.
Para aplicar este procedimiento en otro sitio, la referencia es la documentación de Google sobre noindex: el rastreador debe poder acceder a la página para leer la directiva. Permitir el rastreo y permitir la indexación son decisiones distintas.
4. Corregir la paginación y recuperar rutas equivalentes
En el repositorio /pdf-gratuito/, GenerateBlocks utiliza el parámetro query-a66c71a4-page para cambiar los materiales mostrados. La segunda página tiene contenido distinto de la primera. Por eso se modificó el filtro de canonical para que reconociera la consulta real y los límites de la paginación.
Una página válida conserva su propia dirección canónica. Un parámetro de campaña, como utm_source, se elimina del canonical cuando no cambia el contenido. Los valores inválidos o fuera de rango reciben noindex. Se conservaron las configuraciones canónicas individuales existentes en Rank Math.
Para las rutas antiguas se crearon 28 reglas exactas de redirección 301. La antigua página 1 de la categoría apunta al repositorio actual; las siguientes, a la posición correspondiente. Por ejemplo, /categoria/pdf-gratuito/page/7/ lleva a /pdf-gratuito/?query-a66c71a4-page=7.
Las direcciones AMP heredadas se trataron según la existencia de una entrada o página publicada equivalente. Las rutas eliminadas sin equivalente siguieron respondiendo 404 o 410. El criterio fue recuperar una relación real entre origen y destino, evitando redirigirlo todo a la página de inicio.
5. Comprobar los sitemaps y las respuestas públicas
Una vez definida la política, se contrastó el sitemap, el mapa de URLs facilitado a los buscadores, con el inventario. Reunía 457 URLs: 418 entradas, 25 direcciones del sitemap de páginas, incluida la de inicio, y 14 categorías. Los contenidos del tipo PDF quedaron fuera.
La comprobación pública abarcó esas 457 URLs, las 293 páginas de PDF y 12 direcciones adicionales, un total de 762 verificaciones. Las 28 redirecciones nuevas se revisaron por separado. Así quedaron claras las expectativas de cada grupo: acceso y elegibilidad, acceso con exclusión o redirección.
También se probaron los 66 ejemplos históricos de errores de servidor. Como no se reprodujo ningún 5xx, se solicitó la validación de ese problema concreto. La dirección técnica /wp-*.php, que respondía 403, mantuvo su protección.
6. Corregir los datos estructurados con información real
En el marcado de vídeo, cuatro objetos no incluían la dirección de la miniatura, el campo thumbnailUrl, y dos presentaban problemas de fecha. Se comprobaron los metadatos de los vídeos reales de YouTube y se actualizaron seis objetos VideoObject con sus miniaturas, títulos específicos y fechas originales en formato ISO 8601 con zona horaria.
Se utilizó la fecha de primera publicación de cada vídeo, según la fuente, en lugar del día del mantenimiento. El procedimiento siguió los requisitos de datos estructurados de vídeo de Google. Se conservó el contenido comercial de las páginas.
El informe independiente de indexación de vídeos se interpretó según la función de las páginas: los vídeos complementaban los artículos. No se crearon páginas de visualización artificiales solo para cambiar ese indicador.
En los comentarios se comprobó la retirada previa de microdatos incorrectos, manteniendo visibles los textos. Se solicitaron las validaciones de los avisos para que se procesara de nuevo esa corrección. También se retiró el mecanismo que creaba equivalencias sameAs supuestas entre etiquetas y páginas de Wikipedia.
7. Ajustar los anuncios y el JavaScript compartido
La investigación de la experiencia se centró en los componentes comunes. El historial de campo señalaba problemas de INP, que mide la respuesta a las interacciones, y CLS, que mide los desplazamientos visuales. Se observaron inserciones tardías de anuncios, cambios de altura y un bloque que se recargaba cada diez segundos.
Se eliminó la recarga automática y se conservó la visualización inicial. Se reservó espacio para los anuncios y se mantuvo la secuencia de navegación: párrafo contextual, anuncio y botón de solicitud del PDF. La integración nativa de Ad Inserter pasó a controlar dos bloques de descarga en el procesamiento compartido del contenido, evitando duplicados.
La reserva exigió comprobar las dimensiones tras el renderizado: AdSense aplicaba estilos de altura que anulaban una solución sencilla con min-height. Se ajustaron los contenedores comunes y las reglas adaptativas, sin ocultar ni recortar anuncios.
Un intento intermedio con un búfer HTML no insertó correctamente el anuncio de descarga y se revirtió. La solución final utilizó la función nativa adinserter(). Separar ese intento de la versión final fue necesario para comparar el rendimiento de una página con todas sus funciones operativas.
También cambió el detector de llegada al pie de página: la lectura repetida durante el desplazamiento se sustituyó por IntersectionObserver, conservando el evento existente, su ejecución única y una alternativa con un listener pasivo. Los ajustes quedaron en los archivos compartidos del tema hijo.
8. Verificar la entrega e iniciar validaciones en Search Console
- Abrir las páginas sin iniciar sesión y comprobar el HTML y las cabeceras HTTP.
- Comparar canonical y noindex con la política de cada tipo de URL.
- Revisar los anuncios, botones y la paginación en ordenador y móvil.
- Registrar las mediciones finales y solicitar la validación de los problemas corregidos.
En la intervención de iEducação, esta revisión incluyó el ordenador y un ancho móvil de 390 px. Se vació la caché de WordPress y, de forma selectiva, la de los recursos modificados en Cloudflare.
Se registraron las mediciones finales de PageSpeed para el artículo de letras del alfabeto y la categoría Educação Infantil, en móvil y ordenador. La ronda intermedia con el anuncio incompleto quedó identificada en el historial y separada de la comparación final.
Por último, se iniciaron 11 validaciones: dos de indexación, tres de datos estructurados de vídeo, dos de los avisos de comentarios y cuatro grupos de Core Web Vitals. La solicitud de nueva lectura de robots.txt se registró por separado. En esta intervención no se solicitaron indexaciones individuales.
Qué se comprobó y qué debe seguirse ahora
762 URLs verificadas: todas respondieron HTTP 200 en la comprobación documentada.
293 páginas de PDF: todas con noindex, conforme a la política definida.
28 redirecciones: respuestas 301 hacia destinos equivalentes.
Según el informe técnico, los indicadores anteriores se comprobaron al terminar la implantación. Ninguna URL de los sitemaps tenía un noindex indebido y los hashes de los 735 contenidos publicados permanecieron idénticos.
Son resultados de implantación y verificación. Las 11 validaciones se iniciaron, pero todavía no estaban aprobadas al cierre documentado. Search Console seguía mostrando el historial de Core Web Vitals, que depende de nuevas visitas y del procesamiento de los datos de campo.
En la prueba móvil de letras, la puntuación de rendimiento fue 99 antes y después. El CLS de laboratorio ya era cero en ambas rondas. El Speed Index pasó de 2,925 s a 3,206 s en la medición final. Por tanto, la comparación no demuestra una reducción del CLS histórico ni una mejora general de velocidad. Las puntuaciones finales de accesibilidad, 90 y 92 en las páginas probadas, también mantenían avisos.
El seguimiento debe comprobar el resultado de cada validación, la exclusión coherente de feeds y búsquedas, la consistencia de los sitemaps y la evolución de INP y CLS en campo. Para el tráfico, la comparación debe utilizar periodos equivalentes y considerar consultas, páginas y la estacionalidad escolar brasileña.
Todavía no hay mediciones posteriores que demuestren una recuperación de clics, ventas o ingresos. La intervención creó una base técnica para ese seguimiento. El análisis histórico del tráfico orgánico y las ventas de iEducação corresponde a otro periodo y no debe utilizarse como resultado de estas correcciones.
Método y límites: este artículo sintetiza el informe de la intervención, facilitado por el responsable, con apoyo de IA en la organización y redacción. Los totales internos se atribuyen a ese documento; aquí no se repitió la auditoría de todas las URLs. Los grupos mayores de exclusión tenían un límite de 1.000 ejemplos exportables. Las verificaciones de laboratorio y de diseño cubren las páginas y condiciones descritas.
Para profundizar en la diferencia entre una prueba y la experiencia real, lee también PageSpeed alto y web lenta: qué comprobar antes de optimizar. Las referencias técnicas utilizadas incluyen la documentación de indexación de páginas, noindex, datos estructurados de vídeo, Core Web Vitals y optimización de CLS.
¿Necesitas organizar una corrección técnica de este tipo en tu WordPress? Hablemos por WhatsApp.